برای انتخاب صدا و لحن مناسب برای هر گوینده در فرآیند بومیسازی ویدیو، ابتدا باید از ابزارهایی با قابلیت تشخیص گوینده استفاده کنید تا دیالوگهای هر شخص از دیگری تفکیک شود. سپس با در نظر گرفتن سن، جنسیت، شخصیت و موقعیت احساسی کاراکتر، از میان بانک صداهای هوش مصنوعی یا قابلیت شبیهسازی صدا، یک پروفایل صوتی مجزا با تنظیمات سرعت و زیروبم مناسب برای او انتخاب کنید. این کار به ویدیوی شما عمق بخشیده و آن را از یک صدای رباتیک به یک اثر هنری تبدیل میکند.
صدا فقط ابزاری برای انتقال کلمات نیست؛ صدا حامل احساسات، شخصیت و هویت است. وقتی یک ویدیوی خارجی را تماشا میکنید، قبل از اینکه متوجه معنی کلمات شوید، از طریق لحن و تن صدای بازیگر یا مدرس، به نیت و احساس او پی میبرید. اگر در فرآیند ترجمه و صداگذاری، این هویت صوتی از بین برود، ویدیوی نهایی هرچقدر هم ترجمه دقیقی داشته باشد، نمیتواند با مخاطب ارتباط برقرار کند. در این مقاله به بررسی دقیق روانشناسی صدا و نحوه تنظیم لحن دوبله با استفاده از پیشرفتهترین الگوریتمهای هوش مصنوعی میپردازیم.
اهمیت لحن دوبله در انتقال پیام ویدیو
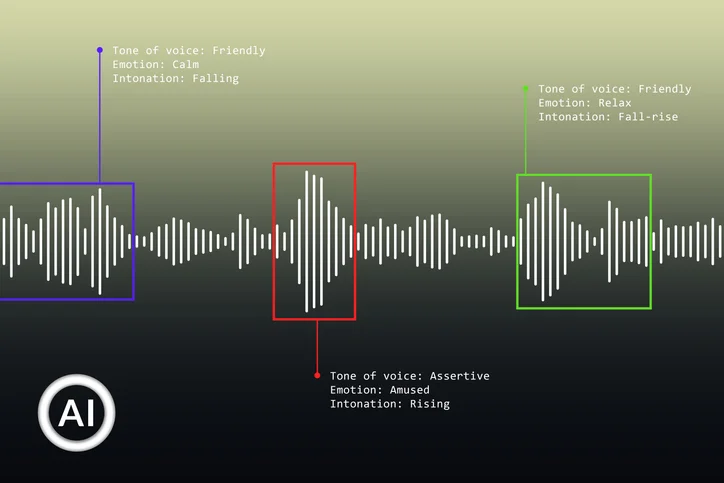
لحن صحبت کردن میتواند معنای یک جمله را به طور کامل تغییر دهد. جمله "کارت عالی بود" میتواند با یک لحن پرانرژی به عنوان تشویق، یا با یک لحن کشدار و سرد به عنوان طعنه بیان شود.
در دوبلههای سنتی، مدیر دوبلاژ با دقت فراوان صداپیشهای را انتخاب میکرد که جنس صدایش با چهره و شخصیت فیزیکی بازیگر روی پرده همخوانی داشته باشد. امروز، شما به عنوان تولیدکننده محتوا نقش مدیر دوبلاژ را بر عهده دارید. اگر یک ویدیوی علمی و جدی را با یک صدای فانتزی و کودکانه صداگذاری کنید، اعتبار محتوای شما به شدت زیر سوال میرود. تنظیم درست لحن باعث میشود مخاطب به سرعت با کاراکترها همذاتپنداری کرده و پیام ویدیو را بدون هیچ مقاومتی دریافت کند.
آناتومی صدا؛ چه چیزی یک صدا را متمایز میکند؟
برای اینکه بتوانید بهترین انتخاب را در ابزارهای اتوماسیون داشته باشید، باید بدانید که یک صدای انسانی از چه اجزایی تشکیل شده است. هوش مصنوعی نیز دقیقاً همین پارامترها را برای ساخت صدای مجازی دستکاری میکند.
زیر و بم صدا (Pitch)
زیر و بم صدا یا پیچ، فرکانس پایه صدای گوینده است. صداهای بم معمولاً تداعیکننده قدرت، پختگی، جدیت و در برخی موارد خطر هستند. در مقابل، صداهای زیر (فرکانس بالا) نمایانگر جوانی، هیجان، استرس یا انرژی بالا میباشند. وقتی در حال تنظیم صدای یک مدیرعامل در یک ویدیوی شرکتی هستید، کاهش ملایم Pitch به رسمیتر شدن فضا کمک میکند.
سرعت ادای کلمات (Pace/Speed)
سرعت صحبت کردن، ریتم ویدیو را تعیین میکند. یک گزارشگر ورزشی با سرعت بسیار بالایی کلمات را پشت سر هم ردیف میکند که نشاندهنده هیجان و اتفاقات سریع است. اما یک راوی مستند نجوم، کلمات را با شمردهگویی و مکثهای طولانی بیان میکند تا عظمت و پیچیدگی موضوع در ذهن مخاطب تهنشین شود. در ویرایشگرهای پیشرفته، شما میتوانید سرعت خوانش متن را بر اساس صحنههای مختلف تغییر دهید.
طنین و بافت صدا (Timbre)
بافت صدا همان ویژگی منحصربهفردی است که باعث میشود صدای دو نفر که با یک سرعت و یک زیروبم صحبت میکنند، باز هم متفاوت به نظر برسد. برخی صداها مخملی و نرم هستند و برخی دیگر زبر و خشن. هنگام انتخاب صدا از بانک صوتی پلتفرمها، باید به این بافت دقت کنید و ببینید آیا با کاراکتر ویدیوی شما همخوانی دارد یا خیر.
تکنولوژی تشخیص گوینده؛ پیشنیاز دوبله حرفهای
قبل از اینکه بتوانید به کاراکترها لحن بدهید، سیستم باید بداند چه کسی در حال صحبت است. اینجا است که تکنولوژی تشخیص گوینده (Speaker Diarization) وارد عمل میشود.
این الگوریتم، موج صوتی ویدیوی آپلود شده را آنالیز کرده و مرزهای صوتی هر فرد را مشخص میکند. در ویدیوهایی که چند نفر حضور دارند، سیستم یک فایل متنی دستهبندی شده ایجاد میکند و جلوی هر جمله، برچسب گوینده اول، گوینده دوم و الی آخر را قرار میدهد.
بدون این سیستم، دوبله چند گوینده به یک فرآیند گیجکننده و طاقتفرسا تبدیل میشود، زیرا شما مجبورید به صورت دستی ثانیه به ثانیه ویدیو را گوش دهید و مشخص کنید چه کسی در حال حرف زدن است. پلتفرمهای ابری این کار را در کسری از ثانیه و با دقت بسیار بالا به صورت خودکار انجام میدهند و راه را برای اعمال تنظیمات اختصاصی هموار میسازند. برای درک بهتر این مکانیزم، مطالعه راهنمای مقاله دوبله دو نفره و چند نفره به شدت پیشنهاد میشود.
راهنمای عملی انتخاب صدا بر اساس نوع محتوا
برای رسیدن به بهترین خروجی، باید ژانر ویدیوی خود را بشناسید و بر اساس استانداردهای ذهنی مخاطب برای آن صدا انتخاب کنید. در ادامه چند سناریوی رایج را بررسی میکنیم.
ویدیوهای آموزشی و دورههای آنلاین
در یک دوره آموزشی، هدف اصلی تمرکز کاربر روی مفاهیم است. صدای مدرس باید واضح، گرم و اطمینانبخش باشد. استفاده از صداهایی که بیش از حد هیجانی هستند، در طولانیمدت باعث خستگی ذهنی دانشجو میشود.
برای این ویدیوها، یک صدای میانرده با سرعت متوسط انتخاب کنید. لحن باید تشویقکننده و در عین حال قاطع باشد. استفاده از مکثهای عمدی بین جملات مهم، به درک بهتر مطلب کمک میکند. شما میتوانید با قرار دادن علائم نگارشی مثل نقطه یا ویرگول در متن ترجمهشده، به موتور هوش مصنوعی دستور دهید تا این مکثهای طبیعی را ایجاد کند.
ولاگها و ویدیوهای سرگرمی یوتیوب
فضای یوتیوب پر از انرژی، برشهای سریع (Jump Cuts) و هیجان است. ولاگرها معمولاً با صدای بلند، تنفسهای کوتاه و ریتم تند صحبت میکنند.
در این حالت، انتخاب یک صدای کتابی و رسمی، قاتل ویدیوی شماست. باید صدایی را انتخاب کنید که لحن محاورهای و پرانرژی داشته باشد. اگر سیستم اجازه میدهد، سرعت صحبت کردن را کمی بالاتر از حد معمول ببرید. از کلمات عامیانه و تکیهکلامهای روزمره در متن استفاده کنید تا سیستم آنها را با لحنی صمیمی و دوستانه بخواند.
مستندها و داستانسرایی (Storytelling)
روایت یک مستند طبیعت یا یک داستان تاریخی، نیازمند صدایی عمیق، گیرا و پرطنین است. صدایی که به مخاطب حس آرامش و کشف ناشناختهها را منتقل کند.
برای راویان مستند، صدای بم مردانه یا صدای پخته زنانه بهترین گزینهها هستند. سرعت خوانش باید کندتر از حالت معمول تنظیم شود. در این ژانر، انتقال احساساتی مثل شگفتی، تعلیق و غم بسیار حیاتی است. پیشرفتهترین موتورهای صوتی قابلیت درک بار معنایی کلمات را دارند و اگر متن شما شامل کلماتی مثل "عظیم" یا "شگفتانگیز" باشد، به طور خودکار وزن و لحن ادای آن کلمه را تغییر میدهند.
مدیریت و کارگردانی دوبله چند گوینده
وقتی پای ویدیوهایی مثل فیلمهای سینمایی کوتاه، پادکستهای تصویری یا مصاحبهها به میان میآید، شما در حال کارگردانی یک گروه از صداپیشگان مجازی هستید. چالش اصلی در دوبله چند گوینده، ایجاد تمایز و کنتراست بین کاراکترهاست.
اگر در ویدیو یک مجری و یک مهمان حضور دارند، هرگز دو صدای شبیه به هم (مثلاً دو صدای بم مردانه از یک جنس) برای آنها انتخاب نکنید. ذهن مخاطب برای تفکیک افراد نیاز به تضاد دارد. یکی از صداها را کمی زیرتر و پرانرژیتر، و دیگری را بمتر و آرامتر انتخاب کنید.
همچنین به دینامیک قدرت در گفتگو دقت کنید. معمولاً کسی که مسلطتر است یا نقش کارشناس را دارد، با ریتم کندتر و مطمئنتری صحبت میکند، در حالی که شخص سوالکننده ممکن است لحنی هیجانیتر و ریتمی تندتر داشته باشد. با تنظیم این پارامترها در پنل کاربری برای هر گوینده، مکالمهای خلق میکنید که کاملاً زنده و واقعی به نظر میرسد.
شبیهسازی صدا؛ تیر خلاص برای طبیعی شدن لحن
اگر ویدیوی شما متعلق به شخص شناختهشدهای است (مثلاً مصاحبهی یک سلبریتی، یا ویدیویی از خودتان که میخواهید به زبان دیگری ترجمه کنید)، بهترین راهکار استفاده از قابلیت Voice Cloning یا شبیهسازی صداست.
در این روش، نیازی نیست به دنبال صدایی در بانک صوتی بگردید که شبیه به کاراکتر شما باشد. هوش مصنوعی صدای اورجینال موجود در ویدیو را نمونهبرداری (Sample) میکند. سیستم زیروبم، لهجه، لرزشهای ریز و تمام مشخصات آکوستیک آن شخص را یاد میگیرد.
سپس متن ترجمهشده به فارسی را دقیقاً با همان لحن و همان صدا تولید میکند. وقتی ایلان ماسک با صدای خودش در حال صحبت به زبان فارسی است، انتقال لحن و احساسات به کاملترین شکل ممکن انجام میشود و مخاطب بالاترین سطح از درگیری و تعامل را با ویدیوی شما تجربه خواهد کرد. برای دسترسی به ابزارهای کنترل زمان و بررسی دقیق نحوه اعمال تغییرات روی فایلها، حتماً سری به بخش راهنمای سایت بزنید.
خطاهای رایج در تنظیم لحن که باید از آنها دوری کنید
کار با هوش مصنوعی نیازمند دقت انسانی است. بسیاری از کاربران تازهکار با رها کردن تنظیمات روی حالت پیشفرض، خروجیهای ناامیدکنندهای میگیرند. در اینجا به برخی از اشتباهات رایج اشاره میکنیم.
یکی از بزرگترین خطاها، نادیده گرفتن طول جملات است. وقتی شما یک جمله طولانی فارسی را در تایملاین یک جمله کوتاه انگلیسی فشرده میکنید، سیستم مجبور میشود برای جا دادن کلمات، ریتم و لحن را نابود کند و کلمات را با سرعتی سرسامآور پخش کند. برای حفظ لحن طبیعی، همیشه سعی کنید متن ترجمهشده را خلاصهتر بنویسید تا گوینده فضای کافی برای ادای درست و با احساس کلمات را داشته باشد.
خطای دیگر، یکنواختی احساسات است. در یک ویدیوی ده دقیقهای، انسانها حالتهای مختلفی را تجربه میکنند. ممکن است در ابتدا بخندند و در میانه ویدیو جدی شوند. اگر از سیستمی استفاده میکنید که اجازه تغییر لحن پویا را نمیدهد، صدای خروجی در تمام ده دقیقه با یک حس ثابت پخش میشود که به شدت خستهکننده است. حتماً در مرحله ویرایش، به علائم نگارشی و بار احساسی کلمات دقت کنید تا موتور تولید صوت بتواند این نوسانات را درک و اجرا کند.
جمعبندی؛ از یک صدای ماشینی تا یک اجرای هنرمندانه
تکنولوژی به سطحی از تکامل رسیده است که دیگر مرزی بین صدای انسان و ماشین وجود ندارد. اما این الگوریتمها برای خلق شاهکار، به کارگردانی شما نیاز دارند. با درک درست از روانشناسی صدا، استفاده اصولی از ابزارهای تشخیص گویندگان، و صرف زمان کافی برای ویرایش و انتخاب لحن مناسب، میتوانید ویدیوهایی تولید کنید که نه تنها اطلاعات را به درستی منتقل میکنند، بلکه احساسات مخاطب فارسیزبان را نیز به بازی میگیرند. در دنیای پررقابت محتوا، این جزئیات و ظرافتها هستند که شما را از دیگران متمایز میکنند.
پرسشهای متداول
آیا سیستم به طور خودکار لحن پرسشی یا تعجبی را تشخیص میدهد؟ بله، موتورهای هوش مصنوعی پیشرفته با تحلیل متن و مخصوصاً علائم نگارشی مانند علامت سوال (?) و علامت تعجب (!)، لحن جمله را به صورت خودکار تغییر داده و کلمات پایانی را با فرکانس مناسبِ آن احساس ادا میکنند.
اگر سیستم نتوانست صدای دو نفر را به درستی تفکیک کند چه کار کنم؟ در صورتی که کیفیت صدای اصلی پایین باشد یا دو نفر همزمان در حال صحبت با صدای بلند باشند، ممکن است درصدی خطا در تفکیک رخ دهد. در این صورت شما میتوانید در ویرایشگر متنی، به راحتی بلوک متنی را ویرایش کرده و برچسب گوینده را به صورت دستی اصلاح کنید.
آیا تغییر سرعت (Speed) باعث رباتیک شدن صدا میشود؟ تغییرات جزئی و ملایم در سرعت (مثلاً تا ۱۰ یا ۱۵ درصد کندتر یا تندتر) با استفاده از الگوریتمهای کشش زمانی مدرن، هیچ افت کیفیتی در پی ندارد. اما تغییرات بسیار شدید و غیرطبیعی قطعاً باعث افت کیفیت بافت صدا خواهد شد.
تفاوت بین لحن رسمی و محاورهای در هوش مصنوعی چگونه اعمال میشود؟ بخش عمدهای از این تفاوت به متنی که شما تایید میکنید بستگی دارد. اگر بنویسید "من میروم"، سیستم آن را با لحن رسمی و کتابی میخواند. اگر آن را به "من میرم" تغییر دهید، سیستم به طور خودکار لحن ادای کلمه را محاورهای، نرمتر و صمیمیتر میکند.