برای ترجمه PDF با جدول و نمودار، نباید متن داخل خانههای جدول را کپی کنید؛ زیرا این کار تمام ساختار سطرها و ستونها را نابود میکند. راهکار قطعی، آپلود کردن فایل در پلتفرمهای هوش مصنوعیِ پردازش اسناد است. این سیستمها خطوط و مرزهای جدول را تشخیص داده، متن انگلیسی داخل هر سلول را به فارسی ترجمه کرده و آن را دقیقاً در همان خانه قرار میدهند. در نهایت، فایل خروجی شما دارای همان جداول، رنگها و عکسهای فایل اصلی است، اما تمام متون آن فارسی شدهاند.
وقتی صحبت از ترجمهی متون ساده به میان میآید، ابزارهای زیادی برای کمک وجود دارند. اما دنیای واقعی پر از اسناد پیچیده است. از کاتالوگ محصولات صنعتی گرفته تا گزارشهای مالی سالانه و مقالات پژوهشی، همگی سرشار از المانهای گرافیکی، چارتهای سازمانی و جداول داده هستند. در گذشته، بومیسازی چنین فایلهایی نیازمند یک تیم دونفره از مترجم و طراح گرافیک (گرافیست) بود. طراح باید تمام جداول را از نو در نرمافزارهای گرافیکی میساخت که کاری به شدت پرهزینه و زمانبر بود. امروز اما، ابزارهای ابری و هوشمند برای ترجمه PDF این جریان کاری را به طور کامل خودکار کردهاند. در این مقاله به بررسی مکانیزم این فناوری شگفتانگیز میپردازیم.
چرا فایلهای PDF در زمان ترجمه به هم میریزند؟
برای درک بزرگی کاری که هوش مصنوعی انجام میدهد، ابتدا باید بدانیم چرا نرمافزارهای معمولی در مواجهه با فایلهای پیدیاف شکست میخورند. فایل PDF در ذات خود یک فایل متنی مثل ورد (Word) نیست؛ بلکه بیشتر شبیه به یک تابلوی نقاشی دیجیتال است.
در این تابلوی نقاشی، هر حرف و هر خط، مختصات (X و Y) مخصوص به خود را دارد. وقتی شما به یک جدول در پیدیاف نگاه میکنید، نرمافزار نمیداند که این یک "جدول" است. نرمافزار فقط چند خط عمودی و افقی میبیند که تعدادی کلمه در میان آنها پراکنده شدهاند. به همین دلیل، وقتی سعی میکنید متن را انتخاب و کپی کنید، کلماتِ ستونهای مختلف با هم ترکیب میشوند و خروجی شما یک متن بیربط و درهمآمیخته خواهد بود. در چنین شرایطی، استفاده از ابزارهای کپیپیس برای متون آکادمیک و پیچیده غیرممکن است.
هوش مصنوعی چگونه ترجمه PDF با جدول را مدیریت میکند؟
پلتفرمهای نسل جدید، فایلها را با رویکردی کاملاً متفاوت میخوانند. آنها مجهز به سیستمهای تحلیل ساختار سند (Document Layout Analysis) هستند که مانند چشم انسان، اجزای بصری صفحه را تشخیص میدهند.
شناسایی مرزها و سلولهای جدول
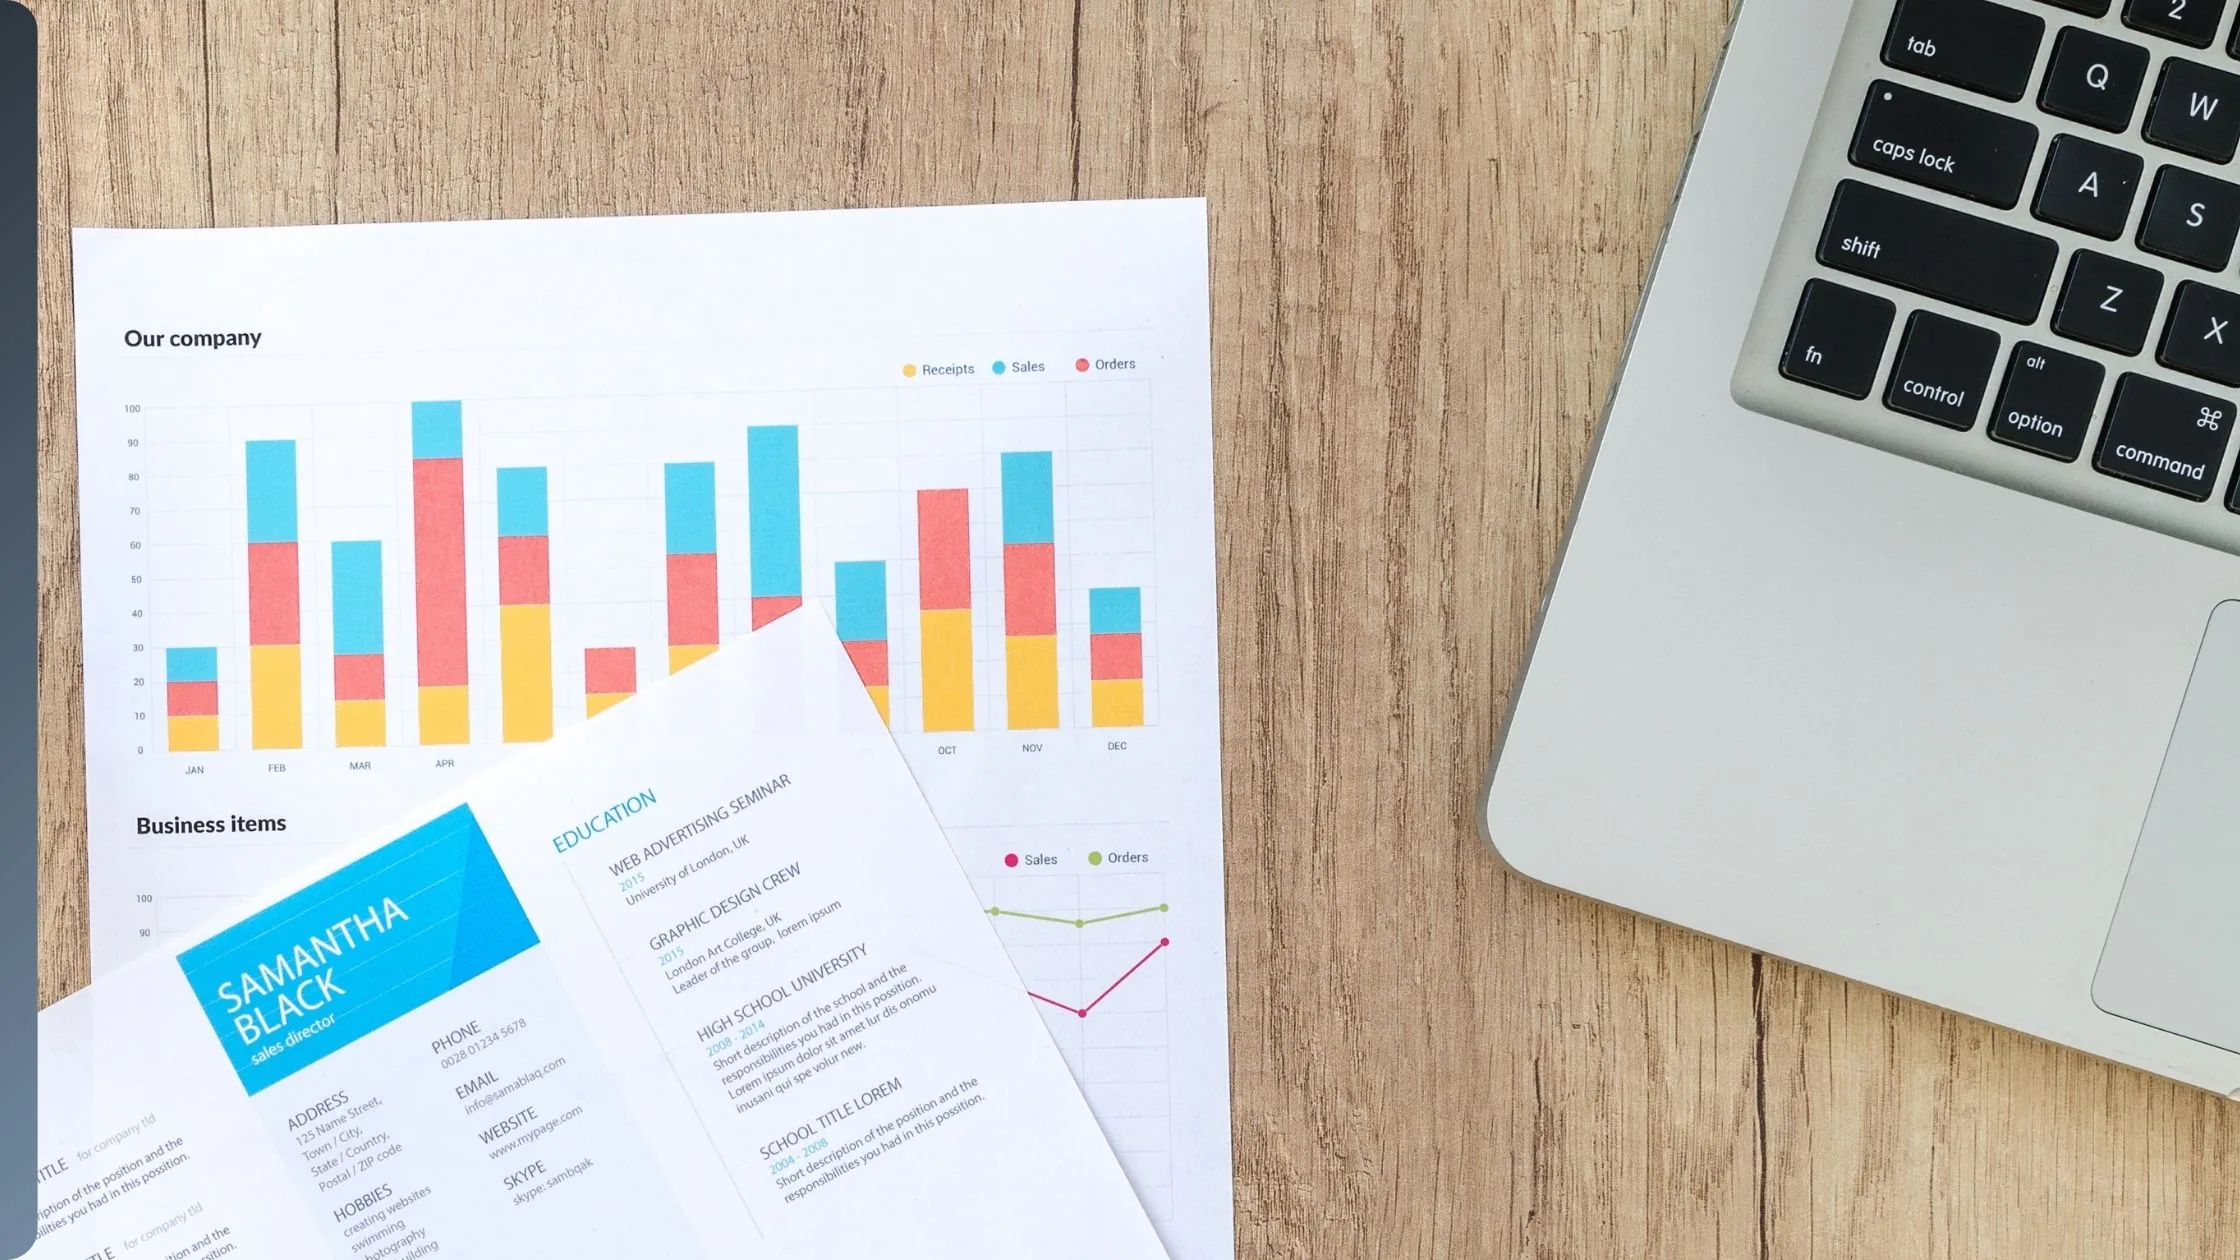
به محض آپلود فایل، هوش مصنوعی صفحه را اسکن میکند. الگوریتمهای بینایی ماشین (Computer Vision) خطوط متقاطع عمودی و افقی را پیدا کرده و آنها را به عنوان یک جدول (Table Object) برچسبگذاری میکنند. سپس سیستم تکتک خانههای این جدول (سلولها) را شناسایی کرده و ارتباط آنها را با سطر و ستون مربوطه درک میکند.
در مرحلهی بعد، متن داخل هر سلول به صورت مجزا استخراج میشود. سیستم متن سلول A1 را به مترجم عصبی میفرستد، معادل فارسی آن را دریافت میکند و سپس متن فارسی را دقیقاً در همان سلول A1 جایگذاری میکند. این فرآیند سلول به سلول انجام میشود تا کل جدول بدون تغییر در سایز و مرزها، به زبان فارسی برگردانده شود. برای مطالعهی بیشتر درباره حفظ کلیت ساختار اسناد، مقاله ترجمه PDF با حفظ قالببندی راهنمای کاملی برای شماست.
تغییر اندازه هوشمند کلمات (Auto-Resizing)
همانطور که میدانید، کلمات فارسی معمولاً طولانیتر از معادلهای انگلیسی خود هستند. اگر سیستم هوشمند نباشد، متن فارسی از کادر سلول جدول بیرون زده و روی خطوط یا سلولهای مجاور قرار میگیرد.
ابزارهای حرفهای دارای الگوریتمهای مدیریت فضا (Space Management) هستند. اگر ترجمه یک کلمه در خانه جدول جا نشود، سیستم به صورت نامحسوس اندازه فونت آن سلول را یک یا دو درجه کوچکتر میکند، یا فاصله بین حروف را کاهش میدهد تا متن دقیقاً در کادر مشخصشده قرار بگیرد و ظاهر گرافیکی جدول بینقص باقی بماند.
چالشهای ترجمه گزارش تجاری و اسناد مالی
شرکتهای بینالمللی برای ارتباط با شرکای ایرانی خود، نیازمند ترجمه گزارشهای سالانه، ترازنامهها و کاتالوگهای قیمت هستند. در ترجمه گزارش، کوچکترین خطا در جابهجایی اعداد میتواند عواقب مالی فاجعهباری داشته باشد.
هوش مصنوعی پیشرفته هنگام پردازش جداول مالی، بین "متن" و "عدد" تفاوت قائل میشود. وقتی سیستم یک جدول پر از ارقام و قیمتها را میبیند، فرمت اعداد را حفظ کرده و فقط تیتر ستونها و توضیحات متنی را ترجمه میکند. در ضمن، اگر ارزهای بینالمللی با نمادهایی مثل دلار ($) یا یورو (€) در جدول باشند، سیستم میتواند آنها را با همان فرمت در کنار اعداد فارسی قرار دهد تا یکپارچگی گزارش مالی از بین نرود.
ترجمه PDF با تصویر؛ معجزهی تکنولوژی نویسهخوان (OCR)
جداول همیشه از خطوط و متن تشکیل نشدهاند. گاهی اوقات در مقالات علمی یا کاتالوگها، سازنده فایل به جای رسم جدول، از آن عکس گرفته و عکس جدول را در فایل قرار داده است. یا ممکن است فایل شما پر از چارتهای دایرهای و فلوچارتهای اینفوگرافیک باشد.
ترجمه PDF با تصویر، پیچیدهترین سطح از بومیسازی اسناد است. در اینجا، سیستم نمیتواند متنی را استخراج کند، زیرا متن جزئی از پیکسلهای یک عکس است. راهکار هوش مصنوعی استفاده از تکنولوژی (Optical Character Recognition) یا نویسهخوان نوری است.
الگوریتمهای تصویرپرداز وارد عکس میشوند، کلمات انگلیسی را روی عکس تشخیص داده و آنها را به متن دیجیتال تبدیل میکنند. سپس یک تکنیک شگفتانگیز به نام نقاشی مجدد پسزمینه (Inpainting) اجرا میشود. سیستم کلمات انگلیسی را از روی عکس پاک کرده و رنگ پسزمینه (مثلاً آبی یا سفید) را در آن قسمت بازسازی میکند. در نهایت، ترجمه فارسی با همان فونت و سایز روی قسمت پاکشده نوشته میشود. نتیجهی کار یک فلوچارت یا اینفوگرافیک کاملاً فارسی است که انگار از ابتدا توسط یک گرافیست ایرانی طراحی شده است.
معکوس کردن ستونها در جداول؛ چالش راستچین بودن
زبان انگلیسی از چپ به راست خوانده میشود و زبان فارسی از راست به چپ. این تفاوت جهت (RTL vs LTR)، در زمان ترجمه جداول مشکلساز میشود.
فرض کنید در یک فایل انگلیسی، ستون اول سمت چپ شامل نام افراد است و ستون دوم سمت راست شامل شغل آنهاست. اگر سیستم فقط متون را ترجمه کند، کاربر ایرانی باید جدول را از چپ به راست بخواند که با منطق ذهنی او در تضاد است. پلتفرمهای تخصصیِ توسعهیافته برای زبان فارسی، دارای قابلیتی به نام Mirroring یا معکوسسازی هستند. آنها به طور خودکار، جهت جدول را قرینه میکنند؛ یعنی ستون اول سمت چپ را به ستون اول سمت راست منتقل میکنند تا چشم خوانندهی ایرانی به صورت طبیعی روی دادهها حرکت کند.
راهنمای قدمبهقدم برای ترجمه اسناد چندرسانهای
اگر یک کاتالوگ محصولات، یک بروشور پزشکی یا یک مقاله پر از داده دارید، دنبال کردن این مراحل به شما کمک میکند تا بهترین خروجی را از ابزارهای ابری بگیرید.
گام اول بررسی فایل مبدأ است. مطمئن شوید فایلی که در اختیار دارید، دارای قفل امنیتی یا پسورد نباشد. اگر فایل شما با کیفیت پایین اسکن شده باشد، دقت تشخیص اعداد و متون در جداول کاهش مییابد. بنابراین همیشه سعی کنید نسخه اورجینال دیجیتال (Export گرفته شده از نرمافزارهای اصلی) را پیدا کنید.
گام دوم آپلود و انتخاب زبان است. فایل را در پلتفرم ابری بارگذاری کرده و زبان مبدأ و مقصد را تعیین کنید. سیستم در پسزمینه شروع به پردازش لایههای گرافیکی، عکسها و جداول میکند.
گام سوم دریافت و بازبینی است. پس از چند دقیقه، فایل PDF جدیدی به شما تحویل داده میشود. حتماً فایل را باز کرده و در کنار نسخه اصلی قرار دهید. به تیتر ستونها در جداول نگاه کنید و از صحت ترجمه اصطلاحات تخصصی مطمئن شوید. اگرچه سیستمهای ابری خطای انسانی را به صفر رساندهاند، اما بازبینی نهایی برای اسناد حساس تجاری و پزشکی همیشه ضروری است.
آیا میتوان خروجی را در نرمافزار Word ویرایش کرد؟
یکی از ویژگیهای جذاب پلتفرمهای مدرن این است که علاوه بر فایل پیدیاف، خروجی را با فرمت DOCX (ورد) نیز در اختیار شما قرار میدهند.
وقتی شما فایل ورد خروجی را باز میکنید، میبینید که جداول به صورت جداگانه (Table Object) ساخته شدهاند و قابل کلیک و ویرایش هستند. این قابلیت برای دانشجویانی که میخواهند فقط یک جدول خاص از یک مقاله را کپی کرده و در پایاننامه خود قرار دهند، یک نعمت بزرگ است؛ زیرا نیازی به رسم مجدد دهها ردیف و ستون نخواهند داشت.
جمعبندی؛ اتوماسیون در خدمت دقت و زیبایی
نگرانی بابت بههمریختگی فرمت و از بین رفتن ساختار گرافیکی، سالها مانع اصلی پژوهشگران و مدیران برای استفاده از هوش مصنوعی بود. اما با تکامل ابزارهای تحلیل اسناد، ترجمه PDF با جدول و نمودار به یک فرآیند ساده و چندثانیهای تبدیل شده است. حفظ یکپارچگی بصری اسناد نه تنها باعث صرفهجویی شدید در زمان و هزینههای گرافیکی میشود، بلکه ارزش و اعتبار محتوای بومیسازیشدهی شما را در چشم مخاطبان فارسیزبان به شدت ارتقا میدهد.
پرسشهای متداول
آیا ابزارهای هوش مصنوعی رنگ و فونت متن داخل جداول را حفظ میکنند؟ بله، الگوریتمهای پردازشگر، رنگ متن (Color Hex) و استایل آن (پررنگ یا مورب بودن) را قبل از ترجمه استخراج کرده و عیناً روی متن فارسی جدید در داخل همان سلول اعمال میکنند.
اگر جدول بین دو صفحه پیدیاف شکسته شده باشد، سیستم چگونه آن را ترجمه میکند؟ سیستمهای پیشرفته صفحات را به صورت پیوسته تحلیل میکنند و متوجه میشوند که جدولِ صفحهی دوم، ادامهی جدولِ صفحهی اول است. بنابراین در ترجمه، یکپارچگی دادهها بین دو صفحه حفظ میشود.
آیا میتوانم فقط صفحات خاصی از یک فایل حجیم را که دارای جدول هستند برای ترجمه انتخاب کنم؟ بله، در پلتفرمهای استاندارد، شما میتوانید پیش از شروع فرآیند اصلی، شماره صفحات مورد نظر خود را (مثلاً از صفحه ۱۰ تا ۱۵) مشخص کنید تا سیستم فقط روی ترجمه گرافیکی همان صفحات متمرکز شود و در هزینهی شما صرفهجویی گردد.
تکنولوژی OCR روی عکسهای تار و بیکیفیت هم کار میکند؟ نویسهخوانهای نوری امروزی با استفاده از شبکههای عصبی قابلیت بالایی در حذف نویز و بهبود تصاویر دارند، اما اگر عکسی بیش از حد تار باشد یا کلمات انگلیسی ناخوانا باشند، احتمال بروز خطای املایی در استخراج متن اولیه وجود دارد.